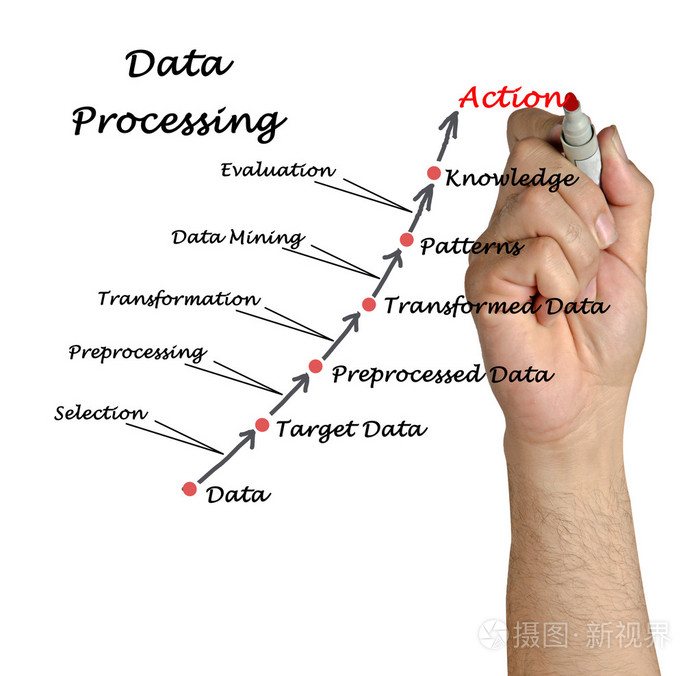
2017云栖大会·杭州峰会上,在线用户行为分析成为数据智能领域的热点议题。随着互联网产品形态日益丰富,用户每一次点击、浏览、搜索、停留等行为都在持续产生海量数据。如何对这些数据进行实时处理与分析,从而支撑个性化推荐、实时风控、运营监控和用户体验优化,成为企业数据架构必须回答的问题。基于流式计算的数据处理体系,正是在这一背景下逐步成熟,为在线用户行为分析提供了低延迟、高吞吐、可扩展的技术路径。
在线用户行为分析的核心诉求在于“快”和“准”。传统批处理模式通常以小时或天为周期进行数据加工,难以满足实时推荐、异常行为拦截等场景对时效性的要求。流式计算将数据视为连续不断的无限事件流,在数据产生的同时即进行处理,使分析结果能够在秒级甚至毫秒级输出。这一转变不仅是技术栈的更新,更是数据思维从“事后统计”向“实时洞察”的演进。
典型的技术架构通常由数据采集、消息传输、流式计算、存储与服务几个层次构成。采集层通过埋点SDK、日志采集组件获取用户行为事件,并将其规范化为统一的事件模型;消息层借助消息队列等高性能传输系统缓冲并分发数据,解耦生产者与消费者;计算层依托流式处理引擎对事件进行窗口聚合、状态管理、复杂事件处理和规则匹配;存储与服务层则将计算结果写入实时存储系统,并通过查询服务对外提供用户画像标签、实时指标看板和告警能力。
在计算环节,流式处理框架需要解决几个关键问题。其一是事件时间与乱序问题。用户行为数据在采集和传输过程中可能出现延迟或乱序,必须借助水位线机制约束乱序范围,保证窗口聚合结果的正确性。其二是状态管理。在线行为分析常涉及用户会话识别、路径分析和留存计算,这些场景需要在长时间窗口内维护累计状态,并要求状态随计算节点的伸缩而均匀分布。其三是容错与一致性。数据管道需要保证故障恢复后结果既不重复也不遗漏,常见做法是结合检查点与精确一次语义的实现机制。
结合具体应用场景,流式计算带来的价值更加直观。在实时画像方面,用户的行为标签可以在事件发生时即时更新,使推荐系统更快捕捉兴趣变化;在实时风控方面,频率类、序列类规则可在毫秒级命中,及时识别异常交易或刷量行为;在运营监控方面,各个环节的转化指标以秒级粒度呈现,帮助运营团队快速定位流失与故障;在个性化触达方面,基于实时行为触发的内容推送与消息提醒,有效提升了用户互动的相关性。
与此流式数据处理在实践中也面临挑战。高并发写入下的数据倾斜需要通过分区策略与热点拆分加以缓解;迟到数据和死信问题需要制定补算与降级规则;实时任务的可观测性需要建立完善的延迟、反压和消费积压监控;系统演进过程中还需兼顾流批一体,避免实时链路与离线链路的指标口径分裂。对此,合理的实践方式包括:建立统一的埋点与事件治理规范,明确幂等与去重逻辑,注重窗口设计与状态规模的可控性,并在架构上保持计算逻辑的复用与组件替换的灵活性。
基于流式计算的在线用户行为分析正在从单一场景走向体系化建设。它以连续数据流为输入,以实时指标、画像与规则为输出,支撑起企业对用户行为的即时理解与快速反应。2017云栖大会杭州峰会上围绕这一方向的探讨,反映出的不仅是对流处理技术的关注,更是对数据处理理念升级的共识:在用户行为数据持续增长的今天,只有将及时、可靠、可扩展的数据处理能力内嵌于业务链路之中,才能把数据转化为可行动的洞察,进而创造真实的业务价值。